 ™
蚂蚁灵波开源通用世界模型 LingBot-World:单次生成近 10 分钟视频
蚂蚁集团旗下具身智能公司蚂蚁灵波 11 月 17 日发布并开源通用世界模型 LingBot-World,代码与模型权重公开,单次生成接近 10 分钟的连贯视频。
发生了什么
LingBot-World 沿用 DeepMind Genie 3 的生成式路线:模型接收用户的动作指令,逐帧生成视觉反馈;灵波团队称,随着规模扩大,模型开始表现出对空间关系、时间连续性与物理规律的理解,例如鸭子蹬水时水面的扰动响应符合物理规律,智能体碰到沙发后转向空地而非穿透。
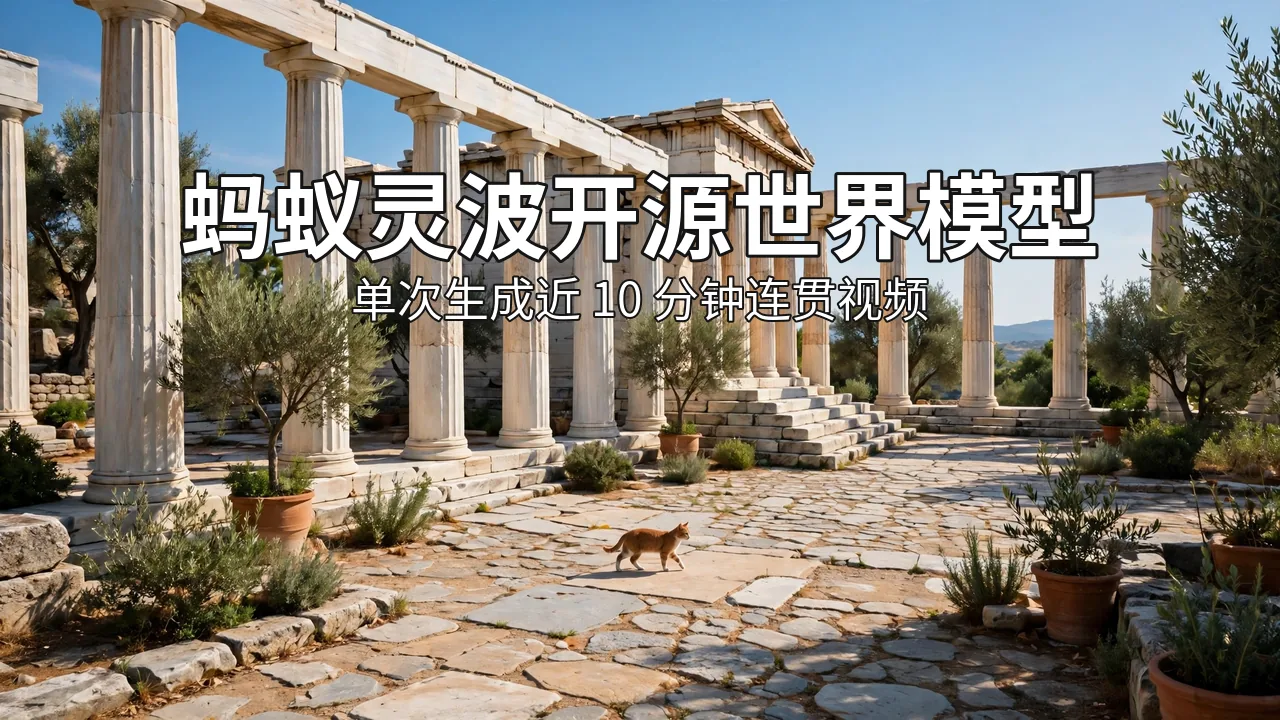
演示视频长 9 分 20 秒,未经剪辑与拼贴,以第一视角从一座破旧的古希腊神庙出发,穿过城市小径与新古典主义建筑群;InfoQ 称,近 10 分钟内画面保持了较为稳定的物理状态与视觉质量,很可能刷新当前视频与世界模型的单次生成长度纪录;视频最后几分钟仍有瑕疵,建筑间的位置关系一度被遗忘。
模型提供 720p 分辨率,支持实时交互,论文称 16 帧每秒生成时延迟低于 1 秒;VBench 测试中领先 Yume-1.5 与 HY World-1.5 等开源模型;同一周内,灵波还发布并开源了空间感知模型 LingBot-Depth 与具身大模型 LingBot-VLA。
关键事实
- 发布:蚂蚁灵波 11 月 17 日发布并开源通用世界模型 LingBot-World,代码与权重公开,不绑定特定硬件或平台
- 长度:演示视频 9 分 20 秒,未经剪辑;InfoQ 称单次生成近 10 分钟连贯视频,很可能刷新当前长度纪录
- 交互:接收用户动作指令生成视觉反馈;论文称 16 帧每秒生成时延迟低于 1 秒
- 评测:VBench 测试中领先 Yume-1.5 与 HY World-1.5 等开源模型
- 数据:训练数据含通用视频、游戏数据与合成渲染数据;游戏数据用自研平台对齐输入与相机参数,合成数据由虚幻引擎生成
- 同周发布:空间感知模型 LingBot-Depth 与具身大模型 LingBot-VLA 同周发布并开源
- 论文:arXiv:2601.20540,2026 年 1 月 28 日提交
为什么重要
LingBot-World 把世界模型从视频生成推向可交互的物理模拟,代码与权重全部公开;同一周三款模型集中开源,使蚂蚁灵波的具身智能基座从幕后走向台前。
订阅 HIMIAO视界
不用注册 · 随时退订推送通知
早报出来时,手机或电脑上弹一条提醒。不用留邮箱。