Reka 发布 19B 全能模型 Rho-1:单个神经网络处理文字、图片、视频与机器人动作
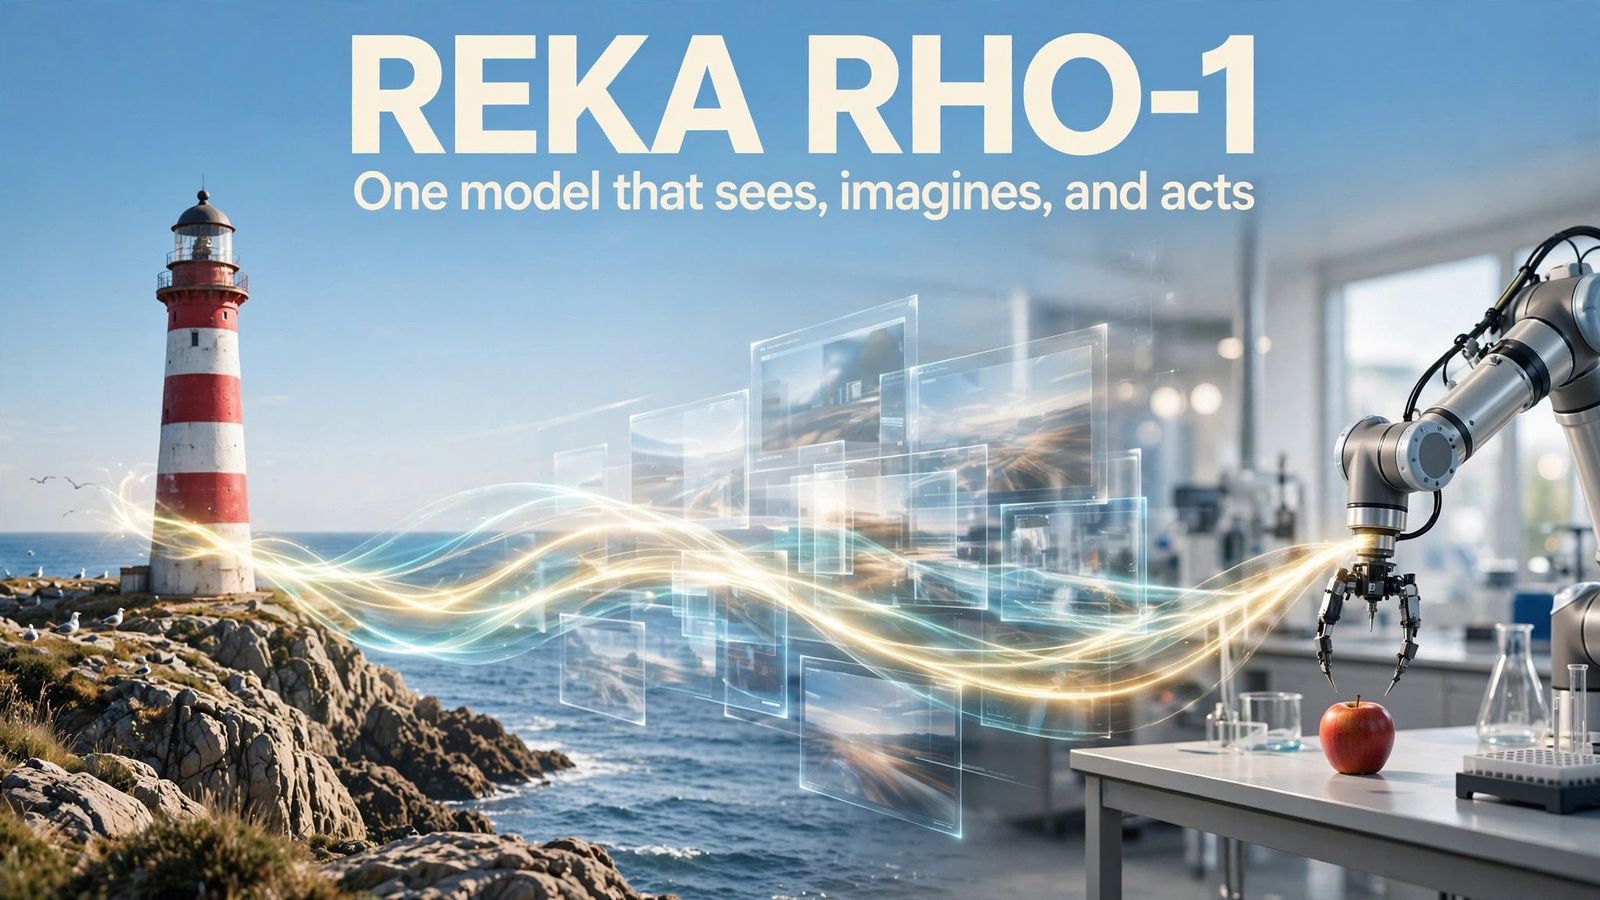
10 月 5 日(周一),Reka AI 发布研究预览版 Rho-1——19B 参数的“全能推理模型”(omni-reasoning model),从零训练。它在一个神经网络里同时理解和生成文字、图片、视频,还能直接输出机器人动作:不用 agent 管线、不用工具调用、不用第二套模型。公司的口号很直白:把现在主流的多模型拼装栈(中央模型规划、层层外包给专职模型)整个“压扁”(collapse the stack)——文字、视觉、机器人动作全部统一成同一上下文窗口里的 token。
事件经过
Reka AI(前 Google DeepMind 资深科学家 Dani Yogatama 创办,2024 年 4 月发布过对标 GPT-4 级的 Reka Core)周一在官方博客发布 Rho-1,THE DECODER、RuntimeWire 同日跟进。演示里是一段连续五轮的对话:先画一张红白条纹灯塔的海岸图,给灯塔画框定位,把画面变成无人机靠近的视频,再把天气改成暴风雪,最后回答“两段视频有什么区别”——全是同一套模型、同一个 KV cache 状态里完成的,没有任何工具调用和第二个模型。
架构上 Rho-1 是“对称的”:每个 transformer block 里两条专家权重流,一条管理解(语言和视觉解析),一条管生成(图像/视频去噪),但共享注意力和同一个 KV cache;离散 token 编文字、推理和指令,连续 token 编图像隐变量、视频帧、机器人动作和本体感知(proprioception)。因为输入和输出是同一套格式,模型生成的东西可以直接喂回上下文——Reka 的说法是:预测下一帧、预测下一句指令、预测下一个动作,是“同一次运算”,而不是三个模型共用一条总线。
关键事实
- 速度数字与图例说明:基础模型视频生成中位数 0.79× 实时速度,可观看的流约 6 秒开始;蒸馏版把去噪轨迹从 99 步砍到 8 步,5.3 秒的片段约 1 秒生成——公司称“比我们测过的任何视频模型都快”。博客还放了一张对比图:多智能体管线路线 13.8 秒 vs Rho-1 实测 7.0 秒。图例显示,管线那一栏标注的是“illustrative”(示意性的),只有 Rho-1 的 7.0 秒是实测。
- 训练:320 块 H100,约 3 个月:Rho-1 是从零训练的对称架构模型。博客承认,多目标训练(生成和理解互不拖累)没有现成共识,训练不稳定是开放研究问题。
- 机器人动作数据:逆动力学模型:机器人领域缺少动作数据——遥操作日志成本高,且绑定特定机身。Reka 用自家的 Inverse Dynamics Model 处理这一问题:普通网络视频没有记录转向角和关节力矩,IDM 观察原始视频、反推出隐含的控制信号,再把这些动作作为原生 token 喂给 Rho-1。演示中展示了从盘子上拿起香蕉、用手柄拿杯子、从手腕相机视角拿苹果(纯文本条件下)。
- Reka 列出的局限性:博客有个单独的 Limitations 章节:长时程漂移(30 秒的流保持照片级纹理,但房间结构会漂成不兼容的布局)、跨视频的目标定位还不可靠、定向编辑跨提示词很脆弱、原生视频分辨率上限 672×384。
- 可用性:研究预览:这只是 research preview——没有放出权重、没有 API、没有第三方独立评测。所有速度数字都是公司自测,demo 场景由公司选定。
背景
Google DeepMind 有 Genie 3(用文本生成可漫游的实时环境);Reka 的 Rho-1 把模拟、推理、动作放进同一个网络。9 月 Reward AI 发布的 OM-1 则用人类演示数据训练机器人策略。Reka 之前的主力是语言模型 Reka Core(2024 年 4 月,benchmark 对标 GPT-4 / Claude 3 / Gemini Ultra),Rho-1 是其转向物理智能的产品,采用对称架构和逆动力学数据管线。
为什么重要
Rho-1 在一个 19B 参数的神经网络里理解和生成文字、图片、视频,并输出机器人动作,不用工具调用;目前只是研究预览,没有权重、API 和第三方评测。
评论
今天
10月12日 星期一- 早报亚马逊被曝洽购 AI 初创 Decart,交易估值约 70 亿美元
共 10 条 · 10月11日
- 三问
- 预测